Google nie indeksuje strony: jak znaleźć przyczynę i ją usunąć
Search Console podaje powód, dla którego strony nie ma w indeksie. Opisujemy najczęstsze statusy z raportu Indeksowanie stron: co znaczą, jak je sprawdzić i jak usunąć przyczynę.
Translated from Polish. Facts and examples refer to the Polish market.
Spis treści
- Najpierw sprawdź, czy strony naprawdę nie ma w Google
- Strona jest nowa albo Google jeszcze jej nie zna
- Strona jest zablokowana: robots.txt, noindex, logowanie
- Błędy serwera, przekierowania i pozorne 404
- Duplikaty i adres kanoniczny
- Strona zeskanowana albo wykryta, ale niezindeksowana
- Treść, której Google nie widzi
- Kolejność działań w skrócie
Opisz, co widzisz w Search Console, a powiemy, ile pracy wymaga naprawa i czy wystarczy jedna poprawka.
Opisz problemNajpierw sprawdź, czy strony naprawdę nie ma w Google
„Nie ma mnie w Google” może znaczyć trzy różne rzeczy: strona nie trafiła do indeksu, jest w indeksie, ale bardzo nisko w wynikach, albo jest w indeksie pod innym adresem, niż się spodziewasz.
Najszybciej sprawdzisz to w Google Search Console, w narzędziu do sprawdzania adresów URL. Wklejasz pełny adres strony w pole wyszukiwania na górze panelu i dostajesz ogólny stan adresu, najczęściej „Adres URL znajduje się w Google” albo „Adres URL nie znajduje się w Google”. W tym drugim przypadku narzędzie zwykle podaje też powód. To narzędzie pokazuje też, kiedy Googlebot ostatnio odwiedził stronę i jaki adres kanoniczny wybrał Google.
Wpisanie w wyszukiwarkę site:twojadomena.pl daje tylko przybliżony obraz. Wynik tego polecenia bywa niepełny, więc traktuj go tylko jako wstępną wskazówkę.
Jeśli problem dotyczy wielu stron, otwórz raport Indeksowanie stron. Pod wykresem znajdziesz tabelę z przyczynami, dla których część adresów nie jest zindeksowana. Każda przyczyna ma swoją nazwę i listę przykładowych adresów.
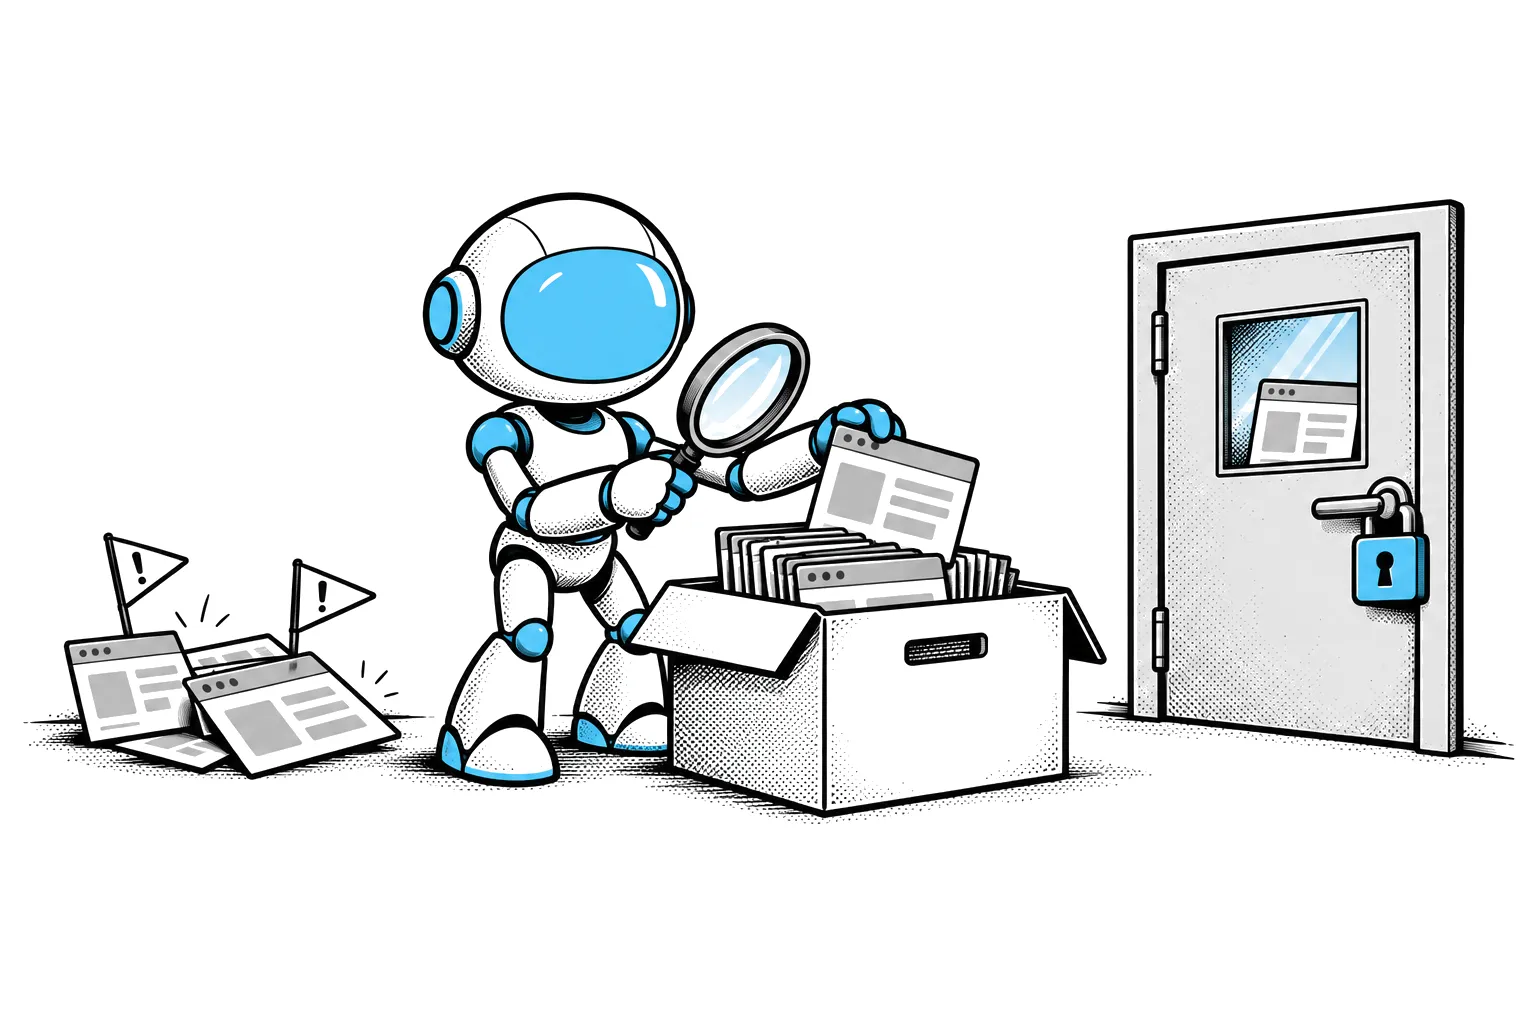
Google znajduje adres
Z linków i z mapy witryny.
- brak linków wewnętrznych i mapy witryny
- nowa strona, której Google jeszcze nie zna
Googlebot pobiera stronę
Czyli skanuje ją.
- blokada w robots.txt
- logowanie albo zapora (401, 403)
- błędy serwera (5xx)
- „Strona wykryta – obecnie niezindeksowana”
Google decyduje o indeksie
- tag noindex
- duplikat i inny adres kanoniczny
- „Strona zeskanowana, ale jeszcze niezindeksowana”
Strona może być w wynikach
Pozycja to osobna sprawa: strona w indeksie może być bardzo nisko.
Strona jest nowa albo Google jeszcze jej nie zna
Nowa strona nie pojawia się w indeksie od razu. Google musi najpierw znaleźć adres, potem go pobrać, a na końcu zdecydować, czy dodać go do indeksu. Według Google samo skanowanie może potrwać od kilku dni do kilku tygodni, a dodanie do indeksu nie ma gwarantowanego terminu.
Co możesz zrobić, żeby Google szybciej trafił na nowe adresy:
- dodaj witrynę do Search Console i prześlij mapę witryny (plik XML z listą adresów) w raporcie Mapy witryn;
- podlinkuj nową stronę z innych stron serwisu, najlepiej z menu albo ze strony kategorii, bo linki pomagają znaleźć stronę użytkownikom i Google;
- po publikacji użyj w narzędziu do sprawdzania adresów opcji „Poproś o zindeksowanie”.
Prośba o zindeksowanie nie daje gwarancji, a liczba próśb jest ograniczona. Google pisze wprost, że wysłanie wielu próśb dla tego samego adresu nie przyspieszy indeksowania. Ma sens po publikacji nowej strony albo po istotnej zmianie treści.
Strona jest zablokowana: robots.txt, noindex, logowanie
Blokady pojawiają się często po wdrożeniu nowej wersji strony: wersja testowa była ukryta przed Google i blokada przeszła razem z nią na stronę produkcyjną.
„URL zablokowany przez plik robots.txt”
Plik robots.txt w głównym katalogu domeny zabrania Googlebotowi pobierania tego adresu. Otwórz twojadomena.pl/robots.txt i poszukaj reguły Disallow, która obejmuje stronę. Jeśli strona ma być w Google, usuń regułę.
Plik robots.txt nie ukrywa stron przed Google. Strona zablokowana w robots.txt może mimo to pojawić się w wynikach, jeśli prowadzą do niej linki. Search Console pokazuje wtedy ostrzeżenie „Strona zindeksowana, ale zablokowana przez plik robots.txt”. Żeby strona naprawdę zniknęła z Google, użyj tagu noindex i pozwól Googlebotowi ją pobrać, bo inaczej nie zobaczy tego tagu.
„URL zawiera tag „noindex””
W kodzie strony jest meta tag <meta name="robots" content="noindex"> albo serwer wysyła nagłówek X-Robots-Tag: noindex. W WordPressie sprawdź, czy w ustawieniach czytania nie jest zaznaczona opcja „Proś wyszukiwarki o nieindeksowanie witryny”, i przejrzyj ustawienia wtyczki SEO dla danego typu treści. Po usunięciu tagu poproś o ponowne zindeksowanie.
Błędy 401 i 403
Statusy „Strona zablokowana z powodu nieautoryzowanego żądania (401)” i „Strona zablokowana z powodu zabronionego dostępu (błąd 403)” znaczą, że serwer wymaga logowania albo odrzuca Googlebota. Bywa to hasło na całej stronie zostawione po testach albo zapora, która traktuje roboty jak atak. Strona publiczna musi być dostępna bez logowania. Jeśli zapora blokuje Googlebota, trzeba go dopuścić, sprawdzając wcześniej, że ruch rzeczywiście pochodzi od Google.
Błędy serwera, przekierowania i pozorne 404
„Błąd serwera (5xx)”
Googlebot dostał od serwera błąd z grupy 500. Błędy serwera mogą być przejściowe, więc przy pojedynczym błędzie sprawdź w teście wersji opublikowanej, czy serwer odpowiada już prawidłowo. Jeśli powtarza się, sprawdź raport Statystyki indeksowania (w Ustawieniach Search Console): pokazuje on, jak często serwer odpowiadał błędem i jak długo trwały odpowiedzi. Wolny albo przeciążony serwer to też powód, dla którego Google pobiera mniej stron.
„Błąd przekierowania”
Przekierowanie nie prowadzi do działającej strony. Najczęściej to pętla (adres A kieruje na B, a B z powrotem na A), za długi łańcuch kolejnych przekierowań albo przekierowanie na pusty lub błędny adres. Sprawdź adres w narzędziu do sprawdzania adresów URL albo w przeglądarce z otwartą zakładką sieci i skróć łańcuch tak, żeby stary adres kierował jednym krokiem na docelowy.
„Strona zawierająca przekierowanie”
Ten status zwykle nie oznacza problemu. Adres przekierowuje na inny, więc sam nie trafi do indeksu. Adres docelowy Google ocenia osobno i może go zindeksować albo nie. Tak powinno być na przykład po migracji. Zajmij się nim, gdy na liście są adresy, które nie powinny niczego przekierowywać, albo gdy przekierowanie prowadzi na niewłaściwą stronę.
„Pozorny błąd 404” i „Nie znaleziono (404)”
Pozorny błąd 404 to strona, która wygląda na pustą albo na komunikat „nie znaleziono”, ale serwer odpowiada kodem sukcesu. Częste przykłady to pusta kategoria w sklepie albo wyszukiwarka wewnętrzna bez wyników. Taka strona powinna zwracać prawdziwy kod 404 albo dostać treść. Pustą kategorię możesz też wykluczyć z indeksu tagiem noindex.
Zwykłe „Nie znaleziono (404)” przy stronach, które celowo usunięto i które nie mają odpowiednika, nie wymaga działania. Jeśli strona została przeniesiona, stary adres powinien mieć przekierowanie 301 na nowy.
Duplikaty i adres kanoniczny
Kiedy kilka adresów pokazuje tę samą lub bardzo podobną treść, Google wybiera jeden z nich jako kanoniczny i zwykle to on pojawia się w wynikach. Pozostałe dostają w raporcie jeden z trzech statusów:
- „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej”: strona wskazuje inną jako kanoniczną, a Google się z tym zgodził. Nic nie trzeba robić.
- „Duplikat, użytkownik nie oznaczył strony kanonicznej”: strona nie wskazuje preferowanego adresu kanonicznego, a Google uznał ją za kopię innej. Jeśli wybrał dobrze, wystarczy dodać tag kanoniczny wskazujący właściwy adres.
- „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik”: wskazałeś adres kanoniczny, a Google wybrał inny. To sygnał, że Twój wybór jest dla Google nieprzekonujący.
W ostatnim przypadku sprawdź w narzędziu do sprawdzania adresów URL, który adres Google uznał za kanoniczny. Potem porównaj obie strony. Jeśli są prawie takie same, zdecyduj, która ma zostać, i połącz je. Jeśli są różne, rozbuduj treść tak, żeby różnica była wyraźna.
W sklepach internetowych źródłem duplikatów są często filtry i sortowanie, które tworzą osobne adresy dla tej samej listy produktów, oraz ten sam produkt dostępny pod kilkoma adresami kategorii. Tu pomaga jednolita struktura adresów i spójne tagi kanoniczne w całym sklepie.
Strona zeskanowana albo wykryta, ale niezindeksowana
Te dwa statusy nie podają konkretnej przyczyny, więc trzeba ją ustalić samemu.
„Strona wykryta – obecnie niezindeksowana” znaczy, że Google zna adres, ale jeszcze go nie pobrał. Według pomocy Google częstym powodem jest to, że pobranie strony mogłoby przeciążyć serwer, więc skanowanie przesunięto na później. Jeśli w raporcie jest dużo takich adresów, sprawdź wydajność serwera w raporcie Statystyki indeksowania i to, czy serwis nie generuje masy mało wartościowych adresów, na przykład z filtrów.
„Strona zeskanowana, ale jeszcze niezindeksowana” znaczy, że Google pobrał stronę i na razie nie dodał jej do indeksu. Google pisze, że strona może trafić do indeksu później i że nie trzeba jej ponownie zgłaszać. W praktyce warto przyjrzeć się samej stronie:
- czy wnosi coś, czego nie ma na innych stronach serwisu i w wynikach Google;
- czy prowadzą do niej linki wewnętrzne z ważnych stron serwisu;
- czy nie jest jedną z setek podobnych stron różniących się tylko nazwą miasta albo produktu.
Jeśli takich adresów jest kilka, mogą trafić do indeksu później, a pomóc może dobre linkowanie wewnętrzne. Jeśli są ich tysiące, sprawdź strukturę całego serwisu: duplikaty, mało wartościowe adresy i wydajność serwera.
Treść, której Google nie widzi
Czasem strona jest w indeksie, ale nie pojawia się na frazy, które ma w treści. Bywa, że Google nie widzi tej treści, bo skrypt, który ją ładuje, nie wykonał się poprawnie, albo strona pokazuje ją dopiero po kliknięciu. Search Console może wtedy zgłosić ostrzeżenie „Strona zindeksowana bez zawartości”.
Sprawdzisz to w narzędziu do sprawdzania adresów URL: kliknij „Sprawdź URL wersji opublikowanej”, a potem „Wyświetl przetestowaną stronę”. Zobaczysz zrzut ekranu i kod HTML strony tak, jak widzi je robot Google-InspectionTool. Jeśli brakuje w nich tekstu, który widzisz w przeglądarce, najważniejsza treść powinna trafić do kodu HTML strony od razu, bez czekania na skrypty. To ważne także dla asystentów AI, bo część ich robotów czyta tylko surowy kod HTML.
Kolejność działań w skrócie
- Sprawdź adres w narzędziu do sprawdzania adresów URL i zapisz status oraz wybrany adres kanoniczny.
- Jeśli problem dotyczy wielu stron, otwórz raport Indeksowanie stron i zacznij od przyczyny z największą liczbą ważnych adresów.
- Usuń blokady: reguły w robots.txt, tag noindex, wymóg logowania.
- Napraw błędy serwera i przekierowań, zwróć prawdziwe 404 tam, gdzie strony nie ma.
- Uporządkuj duplikaty i tagi kanoniczne.
- Przy stronach zeskanowanych lub wykrytych popraw treść i linkowanie wewnętrzne, sprawdź wydajność serwera.
- Po zmianach poproś o zindeksowanie najważniejszych adresów i obserwuj raport przez kolejne tygodnie.
W raporcie Indeksowanie stron możesz po poprawce kliknąć „Sprawdź poprawkę” przy danej przyczynie. Google sprawdzi wtedy ponownie adresy z tej listy i pokaże wynik.
Kiedy potrzebny jest specjalista
Opisz, co widzisz w Search Console, a powiemy, ile pracy wymaga naprawa i czy wystarczy jedna poprawka.
Opisz problemNajczęstsze pytania
Po jakim czasie Google zindeksuje nową stronę?
Według Google samo skanowanie może potrwać od kilku dni do kilku tygodni, a dodanie do indeksu nie ma gwarantowanego terminu. Pomóc mogą mapa witryny w Search Console, linki z innych stron serwisu i prośba o zindeksowanie w narzędziu do sprawdzania adresów URL, choć żadna z tych metod nie gwarantuje szybszego indeksowania.
Czy prośba o zindeksowanie gwarantuje, że strona pojawi się w Google?
Nie. To sygnał dla Google, że strona jest nowa albo zmieniona. Decyzja o dodaniu jej do indeksu zależy od Google, a ponawianie tej samej prośby niczego nie przyspiesza.
Czy robots.txt wystarczy, żeby ukryć stronę przed Google?
Nie. Strona zablokowana w robots.txt może pojawić się w wynikach, jeśli prowadzą do niej linki. Żeby ją wykluczyć, użyj tagu noindex i nie blokuj jej w robots.txt, bo Googlebot musi pobrać stronę, żeby zobaczyć ten tag.
Czy status „Strona zawierająca przekierowanie” to błąd?
Zwykle nie. Adres przekierowuje na inny, więc sam nie trafi do indeksu, a adres docelowy Google ocenia osobno. Warto go sprawdzić, gdy na liście są strony, które nie powinny niczego przekierowywać, albo gdy przekierowanie prowadzi na niewłaściwą stronę.
Dlaczego Google wybrał inną stronę kanoniczną niż ja?
Google uznał, że Twoja strona jest bardzo podobna do innego adresu i że to tamten lepiej reprezentuje treść. Porównaj obie strony: połącz je, jeśli są prawie takie same, albo wyraźnie rozbuduj tę, która ma być osobną stroną.
Przeczytaj też
- Migracja zrobiona poprawnie, a strony wypadły z indeksu: przeprowadzka jako test jakościPoprawna zmiana domeny, a 98% stron poza indeksem. Dwa przypadki z 2026 roku, słowa Muellera i jak odróżnić błąd techniczny od problemu z treścią.Problemy z widocznością
- Googlebot pobrał serwis ponad milion razy, a Google zindeksował 4 adresy: kiedy Google traci zaufanie do serwisuDwa przypadki z odpowiedziami Johna Muellera: dlaczego Google pobiera serwis bez końca i go nie indeksuje oraz kiedy pomaga poprawa, noindex albo 410.Problemy z widocznością
- Strona zeskanowana, ale jeszcze niezindeksowana: co zrobićCo znaczy ten status w Search Console, kiedy go zignorować, skąd się bierze i co naprawdę pomaga stronie trafić do indeksu Google.Problemy z widocznością